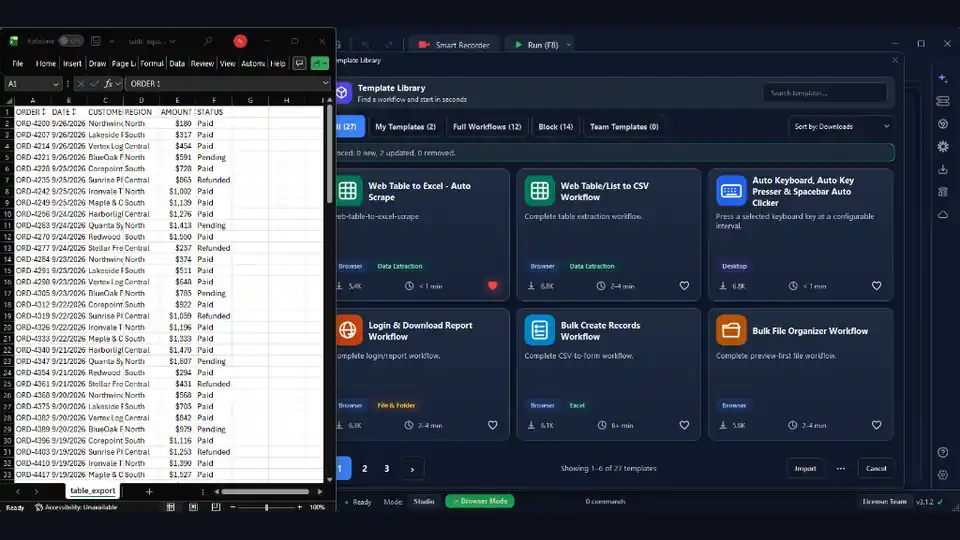
Chép thông tin khỏi một website bằng tay — giá, danh sách sản phẩm, liên hệ, kết quả tìm kiếm — vừa chậm, vừa mụ mị, và âm thầm đầy lỗi. Ngay khi bạn cần cùng loại dữ liệu từ cả trăm trang, hoặc cùng một báo cáo mỗi sáng, nó thôi là một việc vặt và trở thành nút thắt cổ chai. Trích xuất dữ liệu web với RunMacro biến nút thắt đó thành một workflow: nó mở từng trang, đọc đúng những phần tử bạn quan tâm, và ghi kết quả ra Excel hoặc Google Sheets, tất cả mà không cần một dòng code. Bài này hướng dẫn cách dựng một cái thật sự trụ được khi chạy thật.
Vì sao nên tự động trích xuất thay vì copy-paste?
Thu thập thủ công không mở rộng được và không nhất quán. Hai người chép cùng một bảng sẽ định dạng hai kiểu khác nhau, và một người mệt lúc 5 giờ chiều sẽ sót một dòng. Một workflow làm cùng một việc theo cùng một cách ở mọi lần, chạy không cần trông, và có thể hẹn lịch làm mới dữ liệu qua đêm. Cái được thật sự không chỉ là tốc độ — mà là kết quả đáng tin, lặp lại được, để bạn dựng báo cáo lên trên.
Nó còn đổi cả chuyện thứ gì đáng thu thập. Khi lấy 500 dòng chỉ là một lần chạy năm phút không cần trông thay vì mất cả buổi chiều, bạn bắt đầu theo dõi những thứ mà bạn chẳng bao giờ chép tay: bảng giá hằng ngày của đối thủ, một danh bạ đổi mỗi tuần, một tìm kiếm cần chạy lại mỗi sáng.
Bạn trích xuất được những gì
Hầu hết nội dung trang ánh xạ gọn thành một trường bạn có thể đọc vào biến:
• Giá trị văn bản — tên, giá, mô tả, ngày, trạng thái.
• Bảng và danh sách — đọc một cấu trúc dòng lặp lại theo từng mục trong vòng lặp.
• Link và URL — lấy href của một mục để lượt sau ghé từng trang chi tiết.
• Hình ảnh — lưu bằng Tải ảnh web khi bạn cần bức ảnh, không chỉ địa chỉ của nó.
• Ảnh chụp cả trang — chụp trang đã render bằng Chụp màn hình để lưu vết kiểm tra hay bằng chứng hình ảnh.
Cái nằm ngoài phạm vi này: nội dung sau một trang đăng nhập mà bạn không được phép tự động, dữ liệu mà điều khoản của site cấm thu thập, và bất cứ thứ gì bị chặn bởi CAPTCHA. Đó là những ranh giới cần tôn trọng, không phải chướng ngại để vượt.
Bước 1 — Nhắm phần tử theo cách đáng tin
Yếu tố lớn nhất quyết định một scraper có sống sót hay không là cách nó tìm thứ trên trang. Click theo tọa độ cố định vỡ ngay khi bố cục dịch chuyển. Smart HTML của RunMacro thay vào đó đọc và click phần tử theo selector — cấu trúc bên dưới của trang — nên vẫn chạy sau khi thiết kế lại và trên nhiều cỡ màn hình. Chọn phần tử một lần bằng công cụ chọn tích hợp và RunMacro nhớ cách tìm lại.
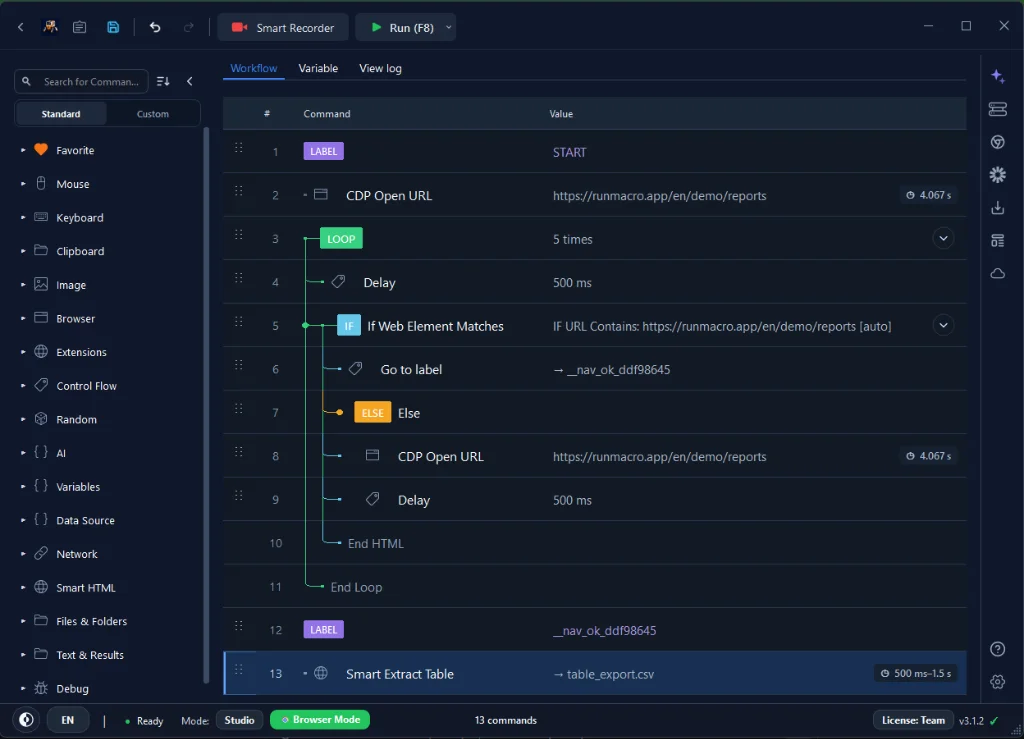
Hai lệnh đi kèm giúp việc này vững. Dùng Chờ phần tử để workflow chờ đến khi nội dung thật sự tải xong thay vì đua với một trang rỗng, và dùng IF phần tử để rẽ nhánh khi một trường thiếu — ví dụ bỏ qua một sản phẩm không có giá thay vì làm sập lần chạy. Hãy ưu tiên selector bám theo cấu trúc có ý nghĩa hơn là tên class tự sinh đổi mỗi lần deploy; một selector neo theo nhãn ổn định sống lâu hơn một tên class băm ngẫu nhiên qua một lần thiết kế lại.
Bước 2 — Chạy Chrome trong nền
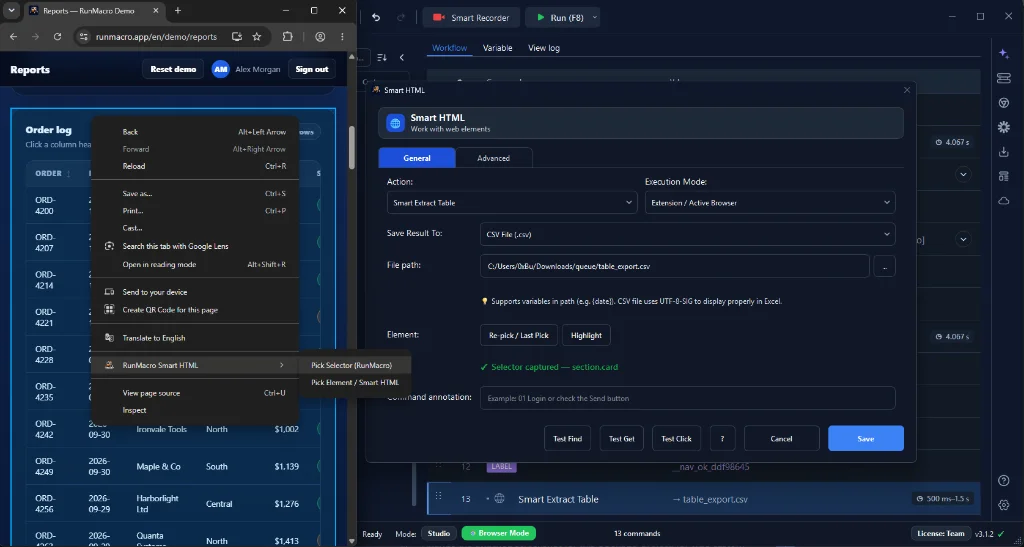
Trích xuất gần như luôn chạy trong Chế độ Nền (Chrome/CDP). RunMacro điều khiển Chrome qua giao thức DevTools, nghĩa là nó đọc DOM sống trực tiếp và không bao giờ phải chiếm chuột thật của bạn. Bạn bấm chạy crawl và vẫn làm việc. Điều hướng bằng Mở URL, trải việc ra nhiều tab bằng Tab mới và Chuyển tab, và gọi Tải lại khi một trang cần làm mới để nạp kết quả mới.
Vì nó đọc DOM đã render chứ không phải HTML thô, nó xử lý được cả những trang mà nội dung do JavaScript vẽ ra sau khi tải — loại trang trả về một tài liệu rỗng cho một lệnh HTTP fetch đơn giản. Đó là lý do chính khiến một crawl chạy qua trình duyệt thành công ở chỗ mà một scraper dựa trên request thô trả về không có gì.
Bước 3 — Đọc trường vào biến và làm sạch
Đọc từng trường vào một biến có tên bằng Khai báo Biến, để giaSanPham và tenSanPham rõ ràng ở các bước sau thay vì là những ô vô danh. Văn bản cào về hiếm khi sẵn sàng để xuất, nên hãy làm sạch ngay trong cùng lượt: bỏ ký hiệu tiền tệ hay khoảng trắng thừa bằng Xóa định dạng text, và rút một phần ra khỏi chuỗi dài — một con số từ "Còn 42 sản phẩm", một ID từ một URL — bằng Trích xuất Regex. Đến lúc một giá trị chạm bước xuất, nó đã là đúng chuỗi bạn muốn đưa vào sheet.
Bước 4 — Xử lý phân trang và nội dung động
Site thật hiếm khi để mọi thứ trên một trang. Mẫu chuẩn là một Vòng lặp: đọc mọi mục trên trang hiện tại, rồi hoặc click nút Tiếp hoặc mở URL trang kế, và lặp lại. Dùng một Nhãn và một điều kiện để vòng lặp dừng sạch khi nút Tiếp biến mất thay vì chạy mãi. Khi site phân trang theo URL — ?page=2, ?page=3 — tăng con số thường đơn giản và vững hơn là đi tìm một nút Tiếp.
Với trang nạp thêm mục khi cuộn, hoặc sau một nút "Tải thêm", hãy thêm một khoảng chờ ngắn sau mỗi lần cuộn hoặc click để các dòng mới kịp hiện ra trước khi bạn đọc. Kiên nhẫn ở đây là thứ phân biệt một tập dữ liệu đầy đủ với một tập rỗng nửa vời — đọc trước khi nội dung tới là lý do phổ biến nhất khiến một crawl âm thầm sót dòng.
Bước 5 — Xuất ra Excel hoặc Google Sheets
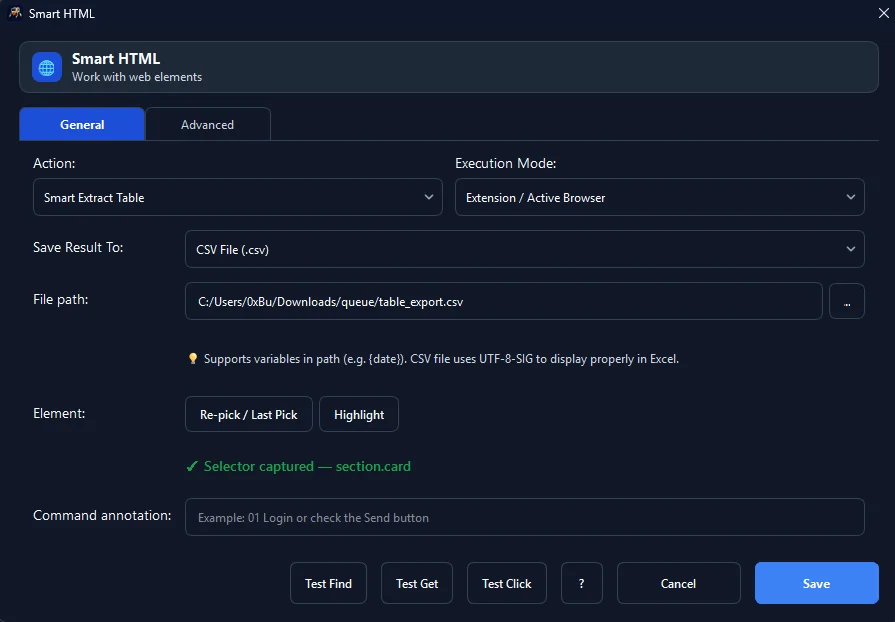
Khi giá trị đã nằm trong biến, hãy ghi ra ngay thay vì giữ tất cả trong bộ nhớ. Ghi kết quả ra CSV dựng bảng tính từng dòng một, cũng có nghĩa là một cú sập giữa chừng vẫn để lại cho bạn những dòng đã thu tới lúc đó. Nếu nhóm bạn sống trên mây, Google Sheets đẩy từng bản ghi thẳng vào một sheet chung cập nhật theo thời gian thực. Ghi khi chạy, không phải để dồn tới cuối, là thói quen cứu các lần chạy dài.
Cào theo lịch
Cái lợi rõ nhất của một crawl không cần trông là một tập dữ liệu tự làm mới. Giao workflow cho Lên lịch chạy để nó chạy mỗi sáng hay qua đêm, và thêm một thông báo Telegram ở cuối để bạn biết dữ liệu mới đã về — hoặc một lần chạy cần xem lại. Kết hợp với xuất-khi-chạy, một crawl theo lịch giữ một sheet luôn mới mà không cần ai ở bàn phím.
Một workflow ví dụ hoàn chỉnh
Đây là hình hài của một extractor sẵn sàng chạy thật:
• Mở URL tới trang kết quả đầu tiên và Chờ phần tử trên khung chứa danh sách.
• IF phần tử kiểm tra có kết quả không; nếu không, nhảy tới cuối.
• Với mỗi mục, dùng Smart HTML để đọc các trường (tên, giá, link) vào biến, rồi Xóa định dạng text để dọn gọn.
• Ghi kết quả ra CSV (hoặc đẩy sang Google Sheets) với các biến đó.
• Click Tiếp bằng Smart HTML, thêm một Delay ngắn, và lặp về bước đọc.
• Khi nút Tiếp biến mất, điều kiện kết thúc vòng lặp và file hoàn tất.
Giữ cho đáng tin và tôn trọng
Một scraper chạy một lần thì dễ; một cái chạy hàng tháng cần chăm. Thêm một Chờ ngẫu nhiên nhỏ sau mỗi lần điều hướng để trang kịp ổn định và yêu cầu giữ nhịp giống người. Ghi log tiến độ — dù chỉ một dòng mỗi trang — để khi một lần chạy dừng, bạn biết chính xác ở đâu.
Cũng quan trọng không kém là ranh giới nằm ở đâu. Tôn trọng điều khoản dịch vụ và quy tắc robots của từng site, giãn nhịp yêu cầu thay vì dội bom máy chủ, và đừng thu thập dữ liệu cá nhân hay nội dung bạn không được phép. Đừng cố vượt một trang đăng nhập bạn không được phép dùng hay một CAPTCHA mà site dựng lên để chặn tự động hóa. Trích xuất chậm hơn, giống người, trong khuôn khổ không chỉ có trách nhiệm hơn — mà còn ít bị chặn hơn nhiều.
Khắc phục sự cố
Chạy xong nhưng file rỗng
Bước đọc đang đua với trang. Thêm hoặc kéo dài một Chờ phần tử trên khung chứa dữ liệu, và xác nhận selector khớp một phần tử có tồn tại khi trang đã vẽ xong.
Chỉ lấy được trang đầu
Vòng lặp phân trang không tiến hoặc không lặp. Kiểm tra cú click Tiếp có trỏ đúng nút thật không, vòng lặp có quay về bước đọc không, và điều kiện dừng chỉ bật khi nút Tiếp thật sự biến mất.
Một trường thỉnh thoảng thiếu và làm dừng cả lần chạy
Bọc phần đọc đó trong một IF phần tử để một giá hay ảnh thiếu được ghi log và bỏ qua thay vì chặn cả crawl.
Giá trị ra kèm ký hiệu hay khoảng trắng thừa
Làm sạch từng giá trị bằng Xóa định dạng text hoặc rút đúng phần cần bằng Trích xuất Regex trước bước xuất.
Site bắt đầu trả về lỗi hoặc chặn
Bạn nhiều khả năng đang yêu cầu quá nhanh. Tăng khoảng chờ giữa các trang, giảm số tab song song, và xác nhận bạn nằm trong khuôn khổ điều khoản của site trước khi tiếp tục.
Câu hỏi thường gặp
Trích xuất dữ liệu từ một trang web mà không cần code thế nào?
Chọn phần tử bằng công cụ chọn selector trực quan, đọc chúng vào biến bằng Smart HTML, lặp qua các trang, và xuất bằng Ghi kết quả ra CSV hoặc Google Sheets. Không cần viết script.
Scraper có vỡ khi website thay đổi không?
Ít hơn nhiều so với loại dựa trên tọa độ. Smart HTML nhắm phần tử theo selector, nên sống sót qua hầu hết thay đổi bố cục; nếu một site bị thiết kế lại nặng, bạn chọn lại phần tử bị ảnh hưởng.
Có xuất thẳng ra Google Sheets được không?
Có. Dùng lệnh Google Sheets để đẩy từng bản ghi vào một sheet chung, hoặc Ghi kết quả ra CSV cho một bảng tính cục bộ.
Có chạy được trên site nạp nội dung bằng JavaScript không?
Có. Vì nó đọc DOM đã render trong Chrome thật, nó thấy nội dung vẽ ra sau khi tải — loại mà một request HTTP đơn giản trả về rỗng. Thêm một khoảng chờ để nội dung động có mặt trước khi đọc.
Có tải được ảnh chứ không chỉ văn bản không?
Có. Dùng Tải ảnh web để lưu file, hoặc đọc URL của ảnh vào biến nếu bạn chỉ cần địa chỉ.
Có chạy theo lịch được không?
Có. Dùng Lên lịch chạy để làm mới dữ liệu qua đêm hoặc mỗi sáng, và thêm một thông báo Telegram để biết mỗi lần chạy đã xong.
Cào dữ liệu web có được phép không?
Tôn trọng điều khoản dịch vụ và giới hạn tần suất của từng site, tránh dữ liệu cá nhân hay sau đăng nhập, và giãn nhịp yêu cầu. Trích xuất có trách nhiệm, giống người, trong khuôn khổ vừa đúng đắn hơn vừa ít bị chặn hơn.
RunMacro có miễn phí không?
RunMacro có bản dùng thử miễn phí. Giới hạn gói hiện tại và bảng giá được liệt kê ở trang bảng giá.
Đi tiếp về đâu
Bắt đầu với một trang và vài trường, xác nhận bản xuất trông đúng, rồi thêm vòng lặp phân trang. Khi mẫu đã chạy, cùng workflow đó mở rộng lên hàng nghìn bản ghi mà không tốn thêm công. Nếu bạn hoàn toàn mới với việc dựng workflow, hướng dẫn bắt đầu trình bày phần cơ bản trước, và tài liệu Smart HTML đi sâu hơn về selector. Khám phá bộ công cụ tự động hóa web và tiện ích Chrome chuyên sâu. Nếu cần điền dữ liệu đã cào vào form trực tuyến, hãy xem giải pháp tự động điền form. Để biến các dòng đã trích thành hành động, hãy xem cách tự động nhập dữ liệu từ Excel. Sẵn sàng dựng một cái? Tải RunMacro.